Nvidia, Vera Rubin'in bant genişliği değerlerini sessizce düşürdü
Nvidia, Vera Rubin için yayımladığı HBM4 ve NVLink 6 bant genişliği değerlerini duyuru yapmadan düşürdü. En büyük kayıp sekiz GPU'lu HGX Rubin NVL8'de.
 Merhabyte Haber Merkezi · · 3 dk okuma
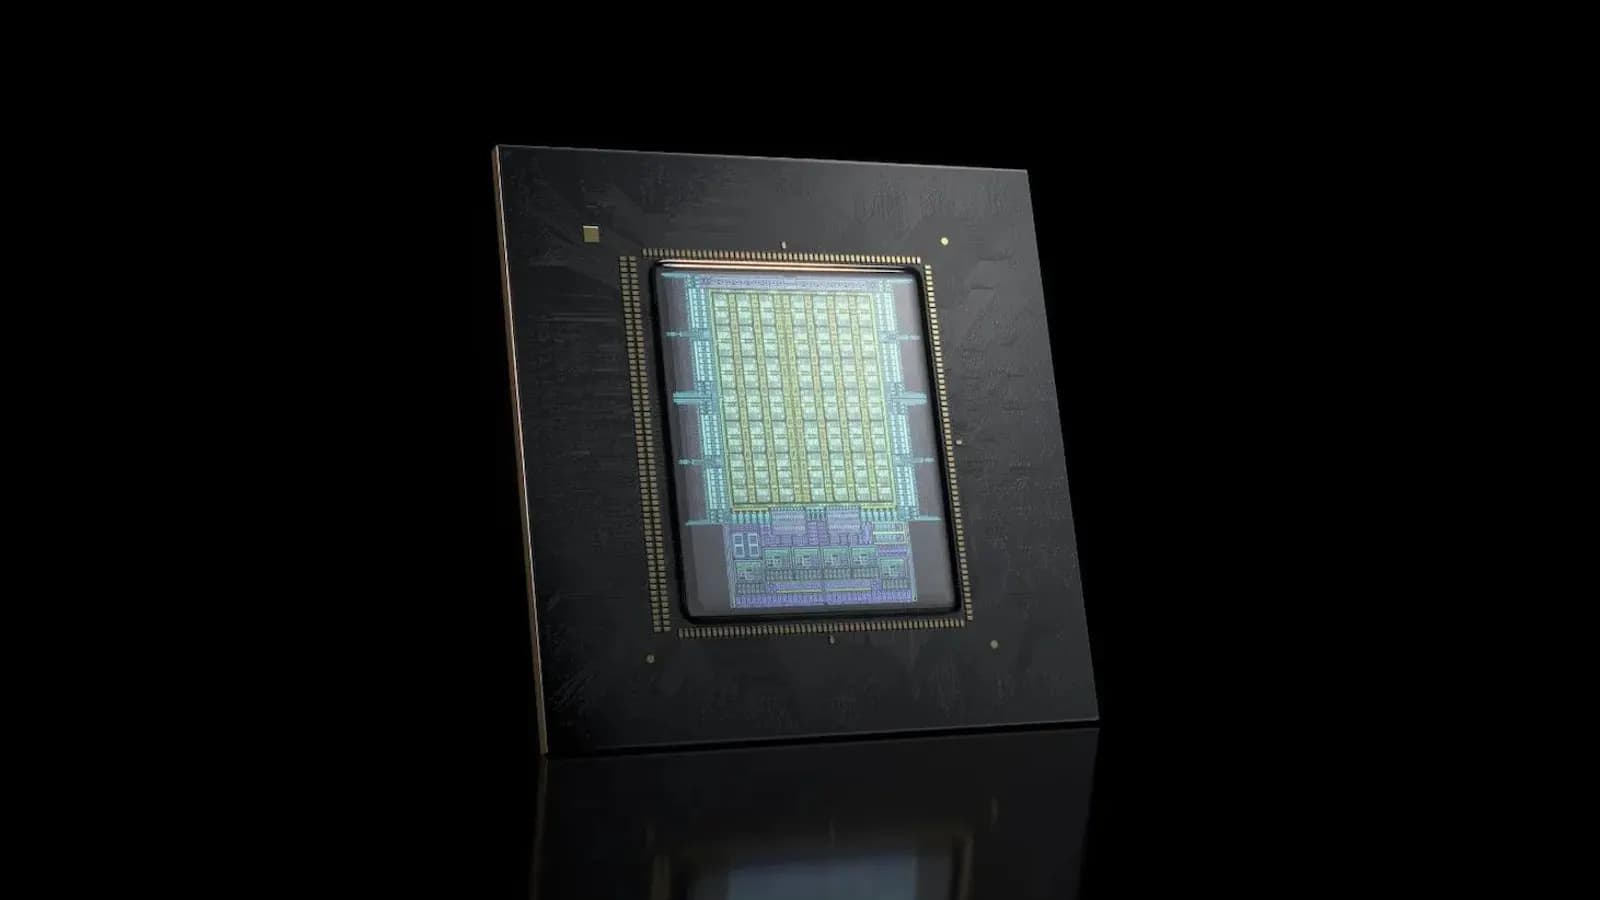
Nvidia, Vera Rubin platformu için yayımladığı bellek ve ara bağlantı bant genişliği değerlerini herhangi bir açıklama yapmadan aşağı çekti. Vera Rubin NVL72 ürün sayfasında her bir Rubin GPU'nun HBM4 bant genişliği artık 22 TB/s yerine 19,2 TB/s, NVLink 6 bant genişliği ise 3,6 TB/s yerine 3 TB/s olarak gösteriliyor. Bu, HBM4 tarafında yaklaşık yüzde 13, NVLink tarafında yaklaşık yüzde 17'lik bir düşüşe karşılık geliyor.
Bellek kapasitesi 288 GB'ta sabit kalırken, seyrek NVFP4 çıkarımda 50 PFLOPS'luk başlık değeri de değişmedi. Ancak raf ölçeğinde toplam bellek bant genişliği 1.580 TB/s'den 1.400 TB/s'ye, toplam NVLink bant genişliği ise 260 TB/s'den 216 TB/s'ye geriledi. İki GPU'lu Vera Rubin Superchip'te de değer 44 TB/s'den 38,5 TB/s'ye indi.
Değişiklik duyurusuz, ürün sayfalarında yapıldı
Revizyon, Nvidia'nın belgelerinin haziran 2026'da kaydedilmiş bir kopyayla karşılaştırılmasıyla ortaya çıktı. Wayback Machine arşivleri düzenlemenin 1 ile 11 Eylül arasında yapıldığını gösteriyor. Yani yeni rakamlar, haber konusu olmadan önce de en az altı hafta sitede yer aldı.
Zamanlama dikkat çekici. Nvidia ağustostaki ikinci çeyrek sonuçlarında Vera Rubin raflarının CoreWeave, Google Cloud ve Microsoft Azure gibi ortaklarda çalıştığını belirtmişti. Mayıs ayında vaat edilen sonbahar üretim sevkiyatlarının başlaması da bu döneme denk geliyor. Bu durum, yeni değerlerin uzak bir hedefi değil, fabrikadan çıkan donanımı tarif ettiğini düşündürüyor.
En büyük kayıp HGX Rubin NVL8'de
Düşüş tüm yapılandırmalarda orantılı değil. Nvidia'nın standart sekiz GPU'lu sunucu kartı olan HGX Rubin NVL8, en ağır darbeyi alan model. Sistem genelinde HBM4 kapasitesi 2,3 TB'tan 2 TB'a, bant genişliği ise 176 TB/s'den 130 TB/s'ye indi; bu yüzde 26'lık bir kayıp demek. NVLink Switch bant genişliği 28,8 TB/s'den 24 TB/s'ye düştü. Yoğun eğitim performansı NVFP4'te 280'den 270 PFLOPS'a, FP8'de 140'tan 130 PFLOPS'a geriledi.
Yükselen tek kalem, çoğu yapılandırmada yüzde 12,5 artan scale-out ağ bant genişliği; Nvidia bunun nedenini açıklamadı.
Rakamlar tam olarak birbirini tutmuyor da. GPU başına tablo hâlâ 288 GB, 22 TB/s ve 3,6 TB/s NVLink değerlerini gösteriyor; bunlar yanında yazılı yeni sistem toplamlarıyla örtüşmüyor. Nvidia'nın temmuzdaki Rubin mimarisi tanıtımı da 22 TB/s'yi anlatmaya devam ediyor. Yeni toplamlar sekiz GPU'ya bölündüğünde GPU başına yaklaşık 16,25 TB/s ve yaklaşık 250 GB çıkıyor. Bu, ya pin başına 8 Gbps'nin biraz altında çalışan sekiz daha küçük HBM4 yığınına ya da GPU başına yığınlardan birinin devre dışı bırakılmasına işaret edebilir. Nvidia'nın 80 GB'lık H100'de de benzer bir yöntem kullandığı biliniyor, ancak şirket hangi yolu seçtiğini söylemiyor.
HBM4 hedefi neden tutmamış olabilir?
JEDEC'in nisan 2025'te yayımladığı HBM4 standardı, pin başına en fazla 8 Gb/s ve 2.048 bitlik arayüzle yığın başına 2 TB/s tanımlıyor. Nvidia'nın hedefi ise bunun çok üzerindeydi. Daha önce yayımlanan bir rapora göre Rubin'in GPU başına bant genişliği hedefi GTC 2025'te 13 TB/s iken eylülde 20,5 TB/s'ye, CES 2026'da 22 TB/s'ye çıkmıştı. Aynı raporda aktarılan bir nota göre SK hynix ve Samsung nihai rakama ulaşmakta zorlanıyordu ve ilk sevkiyatların 20 TB/s civarında olması bekleniyordu.
Pazar araştırmacıları 2025 eylülünde Nvidia'nın tedarikçilerden pin başına 10 Gbps istediğini, hacim yetersizliği veya maliyet artışı hâlinde yükseltmeden vazgeçilebileceğini ya da platform ürünlerinin segmentlere ayrılabileceğini öngörmüştü. Ocak ayında talebin 11 Gbps'yi aştığı ve üç bellek üreticisinin de yeniden tasarıma gittiği bildirildi. Nvidia ise HBM4 ortaklarının üretim sevkiyatları için yolunda olduğunu söylemişti. SK hynix HBM4 geliştirmesini ilk tamamlayan oldu, Samsung ise şubatta 11,7 Gbps ile sevkiyata başladı. Yine de revize edilen tablo, daha düşük bir tavan ve ayrıca düşürülmüş bir HGX katmanı içeren o geri çekilme senaryosuna benziyor. Bu, Nvidia'nın kusursuz bir bellek hedefini kovalamak yerine müşterilerine ürün teslim etmeyi öncelediği şeklinde yorumlanabilir.
Kâğıt üzerinde AMD öne geçti
Rekabet tablosu en azından kâğıt üzerinde değişti. AMD'nin Instinct MI455X'i 12 HBM4 yığınında 432 GB bellek ve 23,3 TB/s sunuyor; bunun için pin başına yalnızca yaklaşık 7,6 Gbps yeterli, yani JEDEC tabanının altında. AMD bant genişliğini hızla değil genişlikle elde ettiği için standart üstü belleğe ihtiyaç duymadı.
AMD temmuz 2026'da Helios'u tanıttığında Vera Rubin NVL72'nin yayımlanmış değerine göre yüzde 6 daha fazla HBM bant genişliği iddia etmişti. Revize edilmiş 1.400 TB/s ile kıyaslandığında Helios'un 1,67 PB/s'si yaklaşık yüzde 19 önde. Nvidia'nın geleneksel güçlü yanı olan scale-up bant genişliğinde ise raf başına 260 TB/s ile eşitlik vardı; şimdi fark yaklaşık beşte bir oranında AMD lehine. Scale-out tarafındaki artış, AMD'nin iddia ettiği yüzde 50'lik üstünlüğü yaklaşık üçte bire indiriyor. Bu rakamların hiçbiri bağımsız testlerle doğrulanmış değil.
Çıkarım iş yükleri için FLOPS'tan çok bant genişliği belirleyici. Nvidia mühendisleri temmuzdaki mimari belgesinde decode aşamasının bellek alt sistemine bağlı olduğunu, asıl önemli olanın tepe değerlerden çok çekirdeklerin belleği ne kadar verimli kullandığı olduğunu savunuyor. Pazarlama dili ise değişmedi: NVL72 sayfası GB200 NVL72'ye kıyasla megavat başına 10 kata kadar daha fazla token ve milyon token başına onda bir maliyet vaadini, değişebileceği dipnotuyla birlikte sürdürüyor.
Yorumlar
Henüz yorum yok. İlk yorumu siz yazın.